


저자: Minhyeong Yu*, Wonduk Seo*, Seunghyun Lee
소속: Enhans, University College London
*동등 기여 저자
논문: DM-Call: Decision-Model-Guided Function Calling with Cumulative Verification Feedback
요약
- AI가 형식에 맞게 함수를 호출하더라도 사용자의 요청과 다른 함수를 선택하거나 입력값을 잘못 넣을 수 있습니다.
- DM-Call은 도구 실행 전에 함수의 입력 형식을 확인하고, 선택한 함수와 입력값이 요청에 맞는지 각각 평가합니다.
- 검증에서 거절된 호출과 피드백을 다음 시도에도 전달해 AI가 앞선 오류를 참고하며 호출을 수정하도록 합니다.
- BFCL 평가에서 Jev를 검증 모델로 사용한 DM-Call은 gpt-5-nano의 함수 호출 정확도를 64.12%에서 74.63%로 높였습니다. 검증에 따른 추론 비용이 추가됐으며, 개선 폭은 생성 모델과 벤치마크에 따라 달랐습니다.
초록
DM-Call은 AI가 제안한 함수 호출을 외부 도구 실행 전에 검증합니다. 먼저 함수가 요구하는 입력 형식을 확인하고, 별도의 판단 모델로 함수 선택과 입력값의 정확성을 각각 평가합니다. 호출이 거절되면 현재 시도와 앞선 시도의 피드백을 생성 모델에 전달해 다음 호출을 수정하도록 합니다. BFCL과 첫 번째 함수 호출을 평가하도록 구성한 API-Bank에서 이 방법을 검증했습니다.
형식에 맞는 함수 호출도 잘못될 수 있습니다
AI 에이전트는 사용자의 요청에 맞춰 도구나 API에서 사용할 함수와 입력값을 정합니다. 사용 가능한 함수 중 하나를 선택하고, 호출에 필요한 입력값을 채웁니다. 형식 검사로 함수가 존재하는지, 필수 입력값이 있는지, 값의 유형이 맞는지 확인할 수 있습니다. 그래도 입력한 값이 사용자의 요청과 다를 수 있습니다.
파리의 날씨를 묻는 요청을 생각해 보겠습니다. 날씨 조회 함수의 도시 입력값에 ‘London’을 넣어도 호출 형식에는 문제가 없습니다. 하지만 실행하면 사용자가 요청하지 않은 도시의 날씨를 조회하게 됩니다.
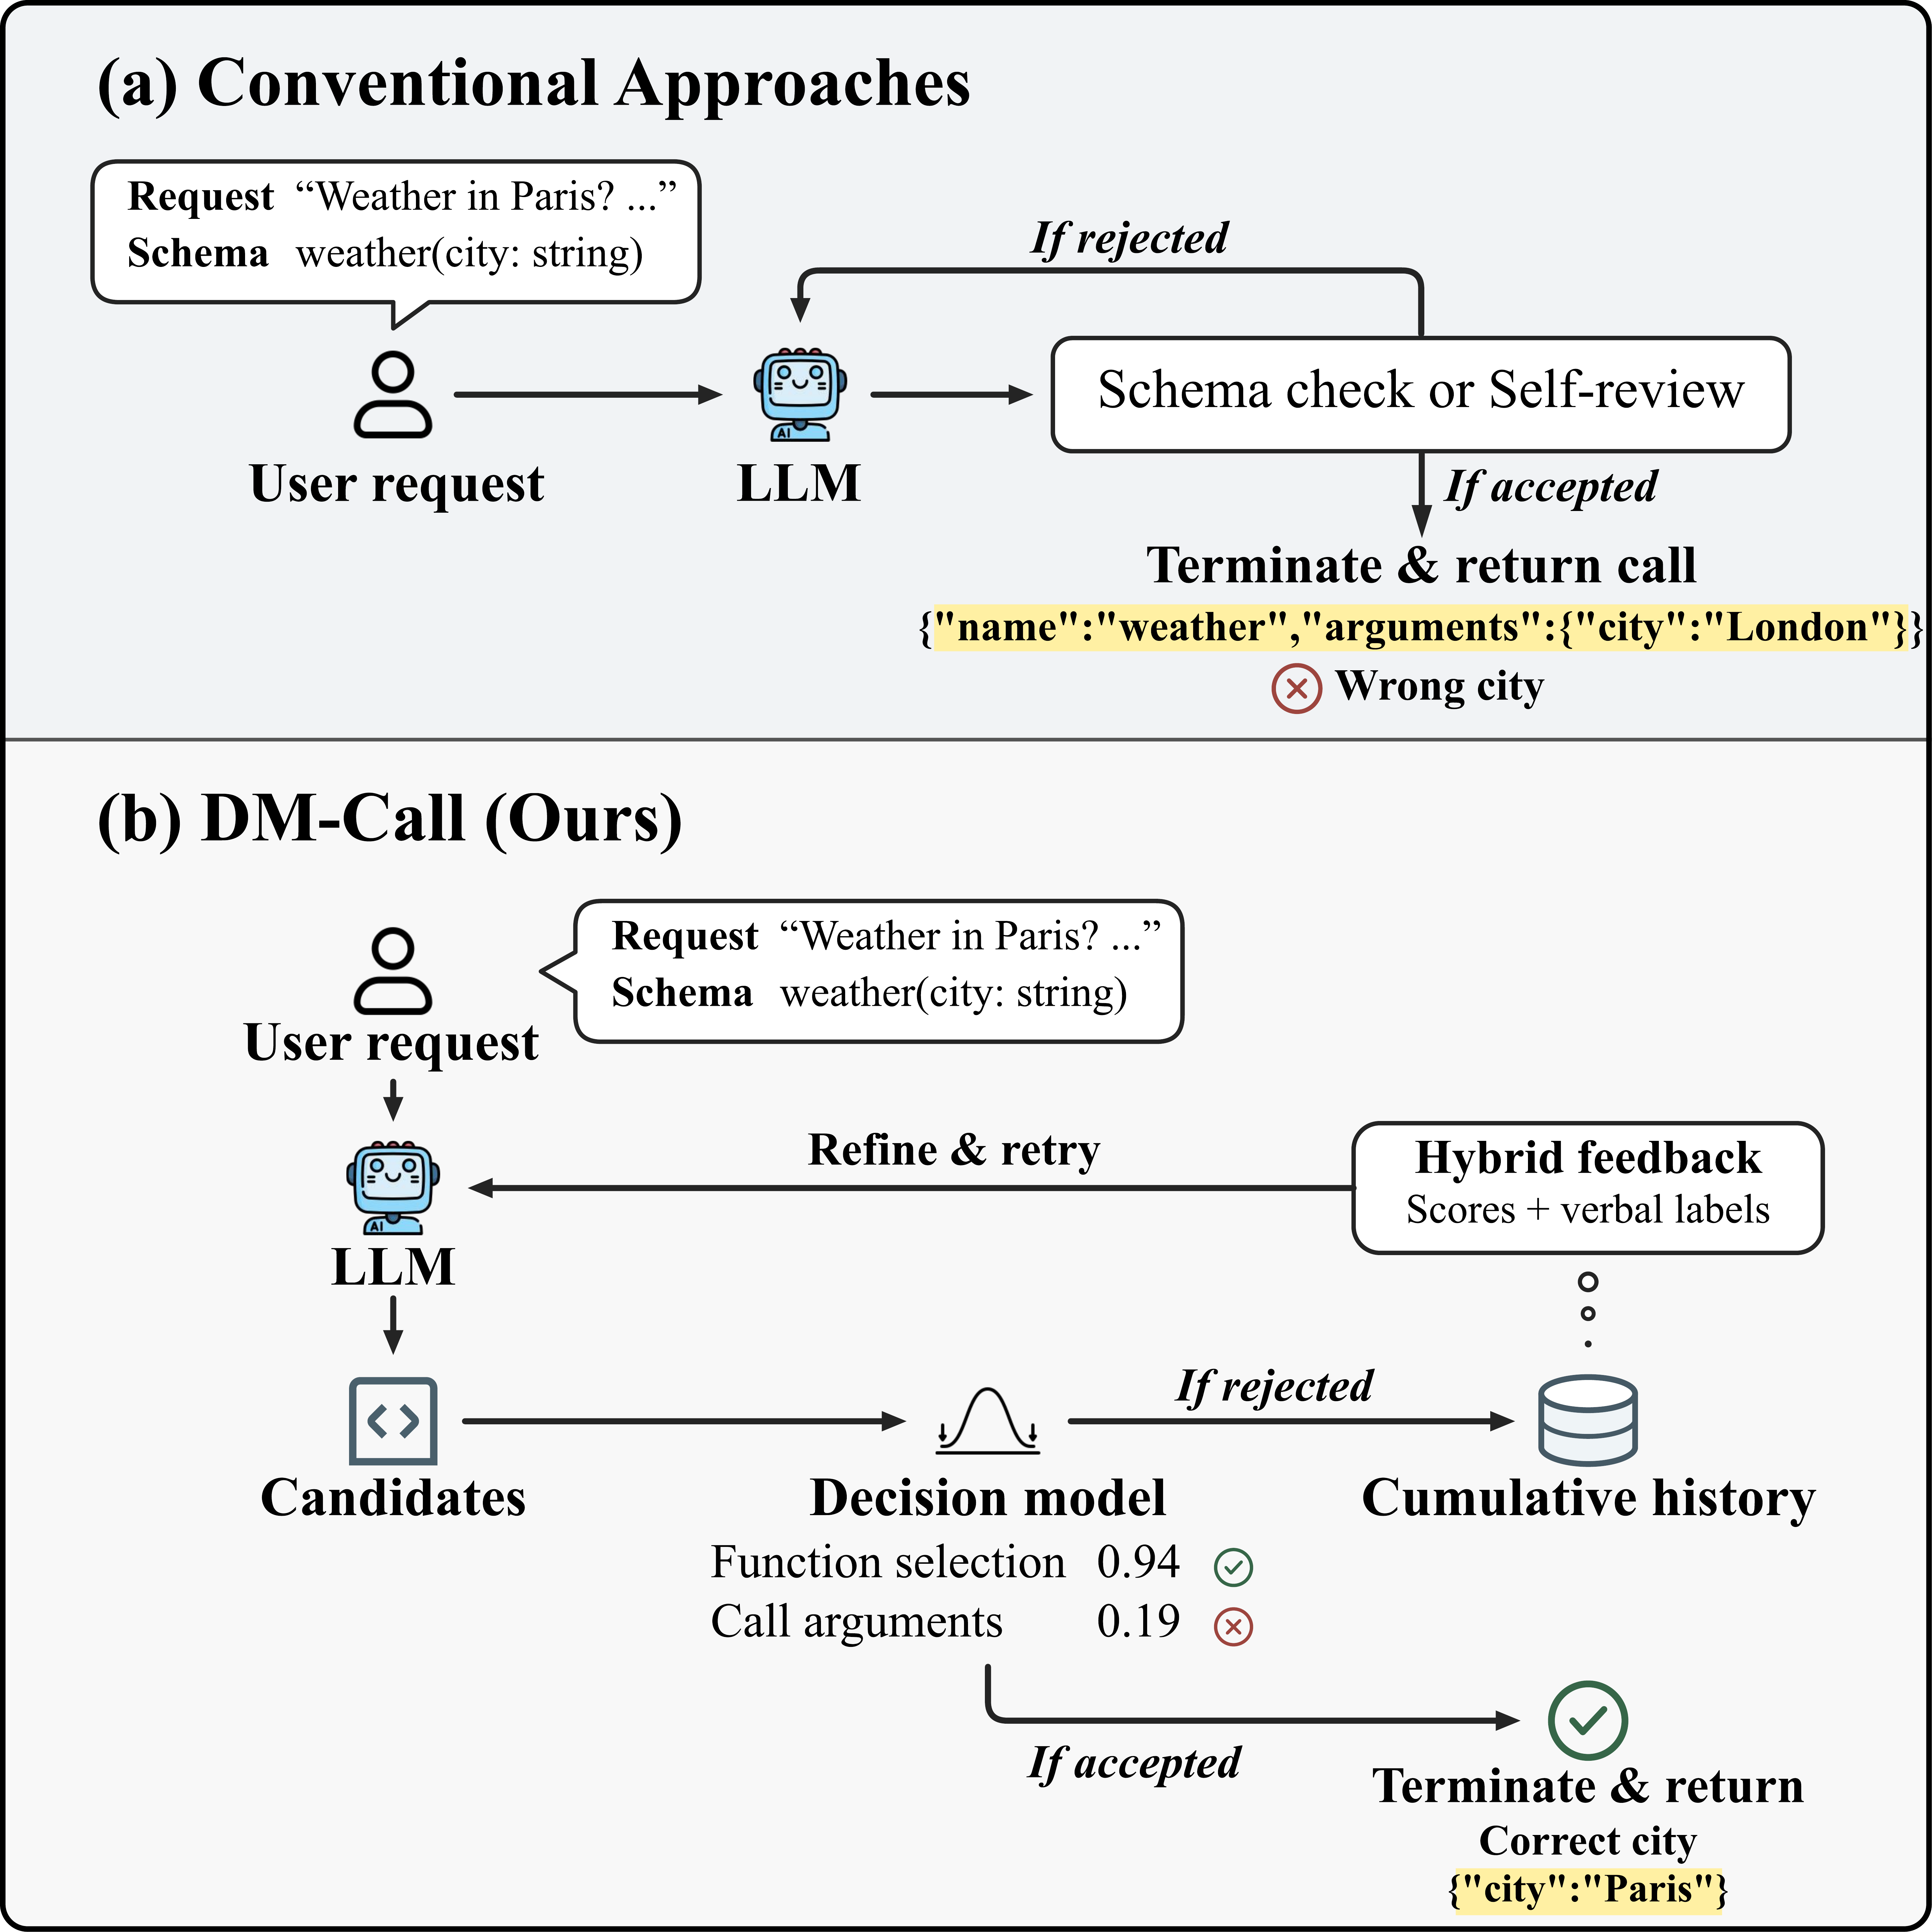
그림 1에서 DM-Call은 날씨 조회 함수의 선택에 0.94점, 입력값에는 0.19점을 부여합니다. 함수는 적절하지만 도시가 잘못됐다고 판단한 것입니다. 호출을 수정한 다음 시도에서는 도시 값에 Paris가 입력됩니다.
입력값은 그럴듯해도 요청에 맞지 않는 함수를 선택할 수 있습니다.
DM-Call은 함수와 입력값을 따로 검증하고 수정합니다
DM-Call은 함수 호출을 제안하는 모델과 이를 평가하는 판단 모델의 역할을 나눕니다. 제안된 호출은 다음 세 가지 항목을 거칩니다.
- 입력 형식: 함수가 존재하는지, 필수 입력값이 있는지, 값의 유형이 맞는지 확인합니다.
- 함수 선택: 선택한 함수가 사용자의 요청에 적합한지 평가합니다.
- 입력값의 정확성: 값이 요청에서 확인되는 내용인지, 올바른 항목에 입력됐는지 평가합니다.
호출이 검증을 통과하지 못하면 DM-Call은 거절된 호출, 평가 점수, 입력 형식 오류를 기록합니다. 생성 모델은 이 기록을 전달받아 다음 호출을 만듭니다. 피드백에는 점수와 함께 정확성에 대한 언어적 평가도 포함됩니다.
식혜 만드는 법을 묻는 요청에서 생성 모델은 처음에 일반 웹 검색 함수를 선택했습니다. 검색어는 그럴듯했지만 함수 선택 점수가 낮았습니다. 다음 시도에서는 요리법 검색 함수를 선택했고, 함수와 입력값 모두 검증을 통과했습니다.
검증과 수정 중에는 외부 도구를 실행하지 않습니다. 정해진 재시도 횟수 안에서 처음 검증을 통과한 호출을 반환합니다. 끝까지 통과한 호출이 없으면 최초 제안으로 돌아가며, 첫 응답에서 함수 호출을 제안하지 않은 경우에는 검증 없이 반환합니다.
실험 설정
DM-Call은 평가 범위가 다른 두 가지 함수 호출 벤치마크에서 검증했습니다.
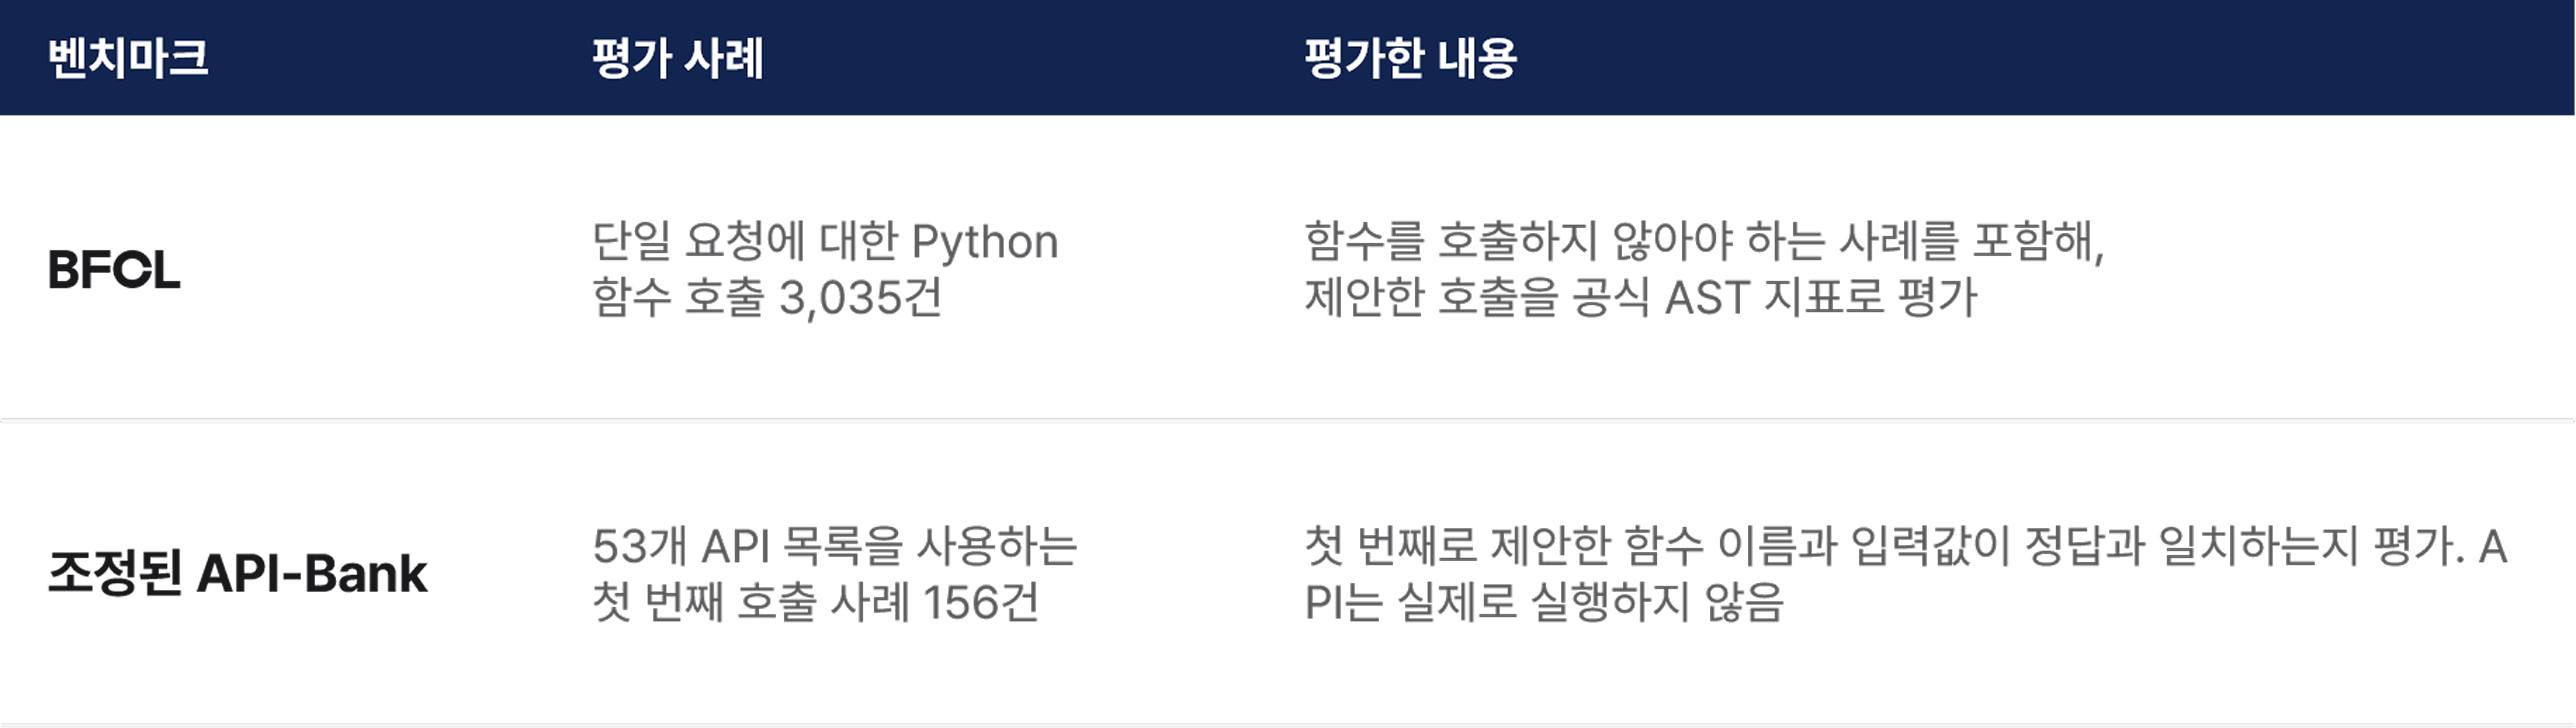
함수 호출을 생성하는 모델로 gpt-5-nano, gpt-5.4-mini, claude-sonnet-5.5, gemma-4-31b-it을 사용했습니다. 호출을 검증하는 판단 모델은 Jev 1.13.0과 PPLX Decider v1.1 27B 두 가지입니다. Jev는 DM-Call의 검증 성능을 확인하는 데 사용한 모델 중 하나입니다.
비교 대상에는 모델이 처음 만든 호출을 그대로 사용하는 방식, Self-Refine, 멀티 에이전트 방식인 MAD-FC와 PF-FC가 포함됐습니다. DM-Call은 검증 기준점을 0.5로 설정하고 최대 세 번의 수정 시도를 허용했습니다. 주요 결과는 세 차례 실행한 값의 평균입니다.
실험 결과: 정확도, 누적 피드백, 비용
BFCL에서 Jev를 검증 모델로 사용한 DM-Call은 네 가지 생성 모델 모두에서 직접 호출보다 높은 정확도를 기록했습니다.
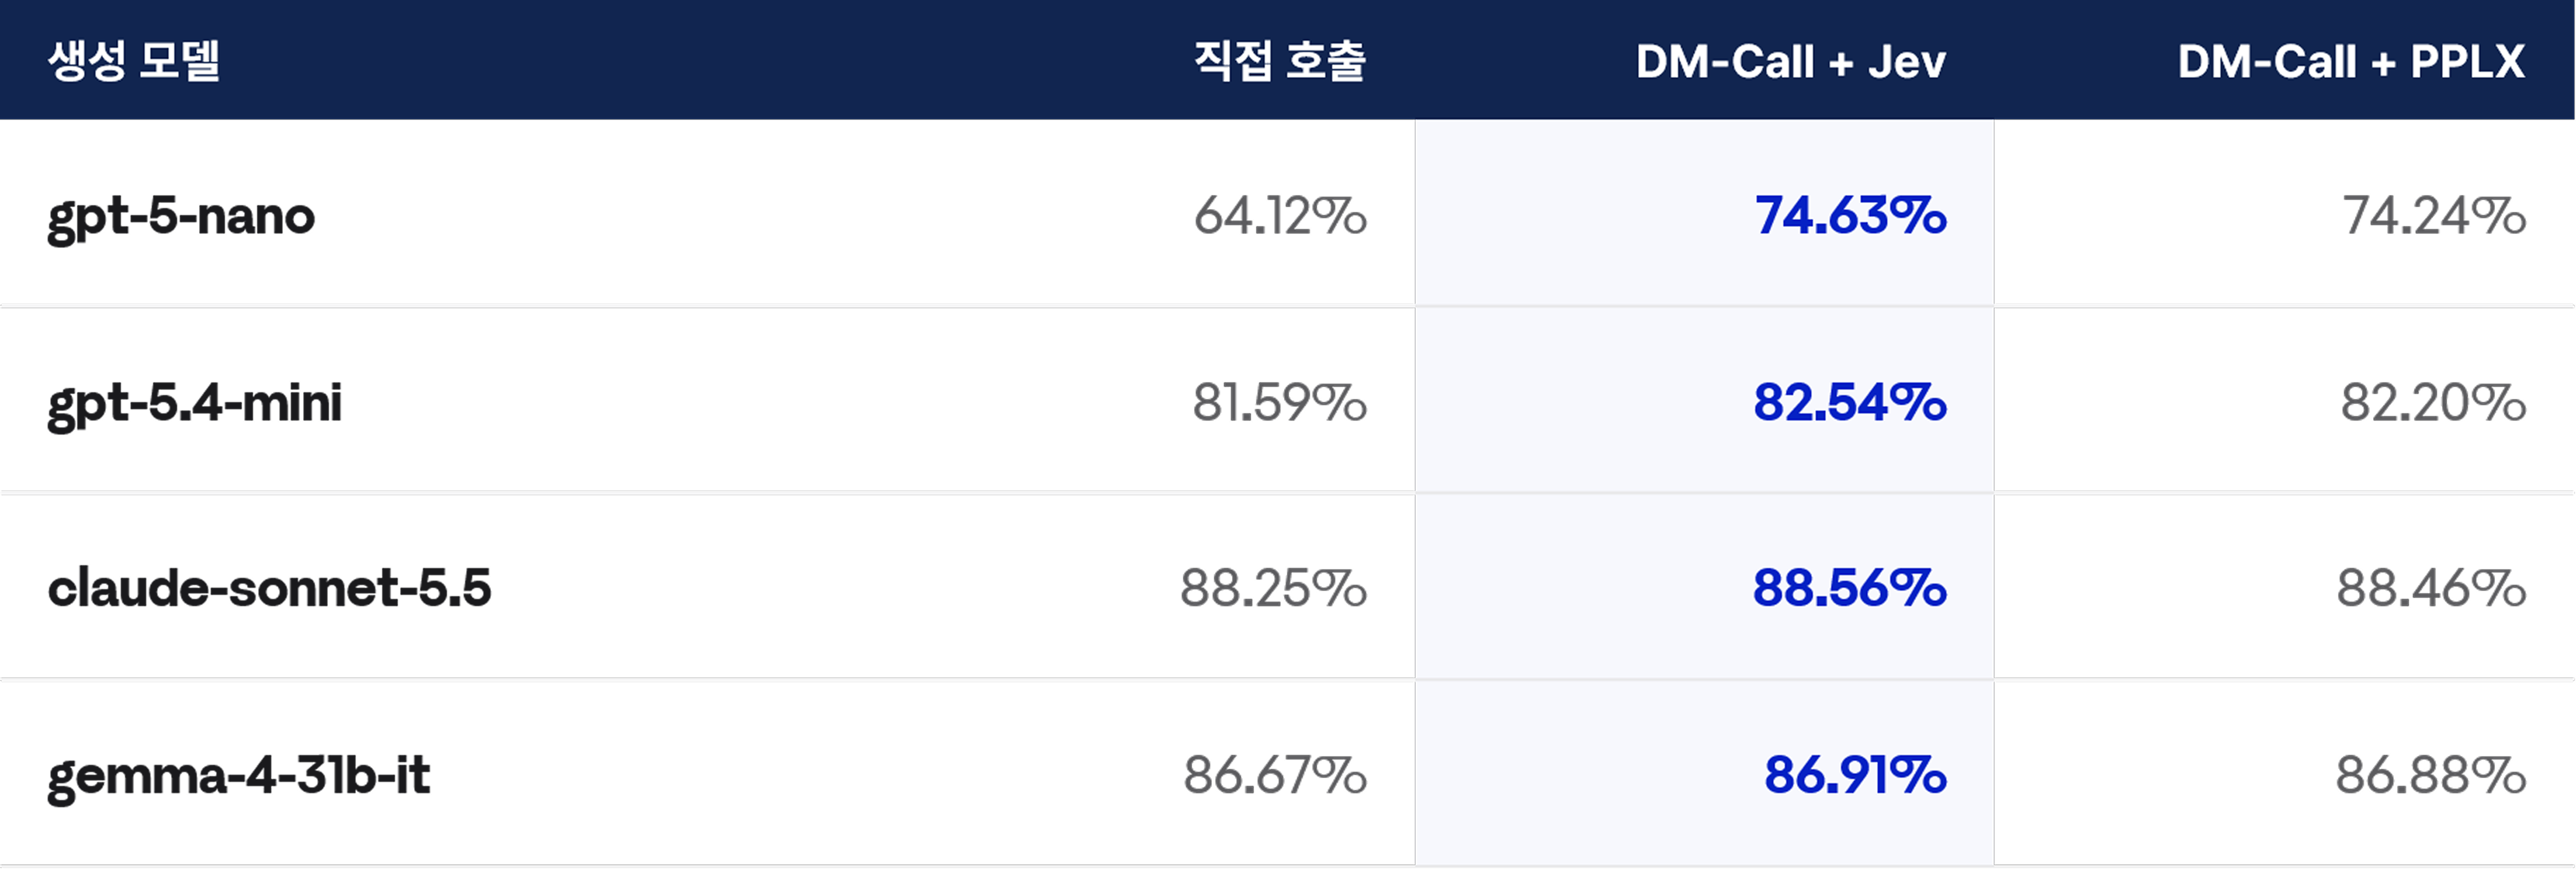
가장 큰 개선은 gpt-5-nano에서 나타났습니다. Jev로 검증했을 때 정확도가 10.51%p 높아졌습니다. 나머지 세 모델은 직접 호출 정확도가 이미 더 높았고, 개선 폭은 상대적으로 작았습니다. 조정된 API-Bank에서 gpt-5-nano는 직접 호출 61.32%, DM-Call과 Jev를 사용했을 때 64.32%를 기록했습니다. 같은 평가에서 비교 방식 중 하나인 PF-FC는 70.09%를 기록해, DM-Call이 모든 결과에서 가장 높은 점수를 낸 것은 아닙니다.
앞선 검증 결과를 계속 전달하는 것도 정확도에 영향을 줬습니다. gpt-5-nano와 Jev를 사용한 별도의 BFCL 분석에서 직전의 거절 결과만 남겼을 때 함수 호출 정확도는 73.05%였습니다. 이전에 거절된 호출의 피드백까지 모두 유지했을 때는 74.32%였습니다. 이 수치는 위 표의 주요 결과와 별도로 실행한 분석 결과입니다.
검증과 수정에는 추가 추론 비용이 듭니다. 해당 평가에서 gpt-5-nano의 전체 추론 비용은 직접 호출 시 0.167달러, DM-Call과 Jev 사용 시 0.525달러였습니다. DM-Call의 정확도는 직접 호출보다 높았고 비용도 더 들었습니다. 실험에서 비교한 여러 수정 방식보다는 비용이 낮았습니다.
허용하는 수정 횟수는 응답 시간에도 영향을 줍니다. 최대 세 번 수정할 수 있도록 했을 때 평균 소요 시간은 4.0초로, 직접 호출의 2.6초보다 길었습니다. 수정 가능 횟수를 세 번에서 열 번으로 늘리면 정확도는 1.8%p 더 높아졌지만, 95백분위 소요 시간은 9.7초에서 24.3초로 늘었습니다. 수정 기회를 얼마나 줄지는 정확도와 처리 시간을 함께 고려해 정해야 합니다.
결론
DM-Call은 판단 모델로 함수 선택과 입력값의 정확성을 각각 검증하고, 거절된 호출의 누적 피드백을 반영해 다음 호출을 수정합니다. 이번 평가에서는 직접 호출 방식보다 함수 호출 정확도가 높았습니다. 개선 폭은 생성 모델과 벤치마크에 따라 달랐으며, 검증에는 추가 추론 비용과 시간이 들었습니다.

in solving your problems with Enhans!
We'll contact you shortly!